

要把PDF内容嵌入网页,或是后续整理成网页文件,先去这个在线转换平台:www.pdf.cn,用极轻PDF的PDF转HTML工具处理就行。电脑上已经装了Acrobat或者ABBYY FineReader的,也可以直接用软件自带的导出功能。操作之前先确认原PDF能正常打开,要是扫描版文件,得提前留意下文字识别的效果。
方法一:用极轻PDF在线转换 HTML
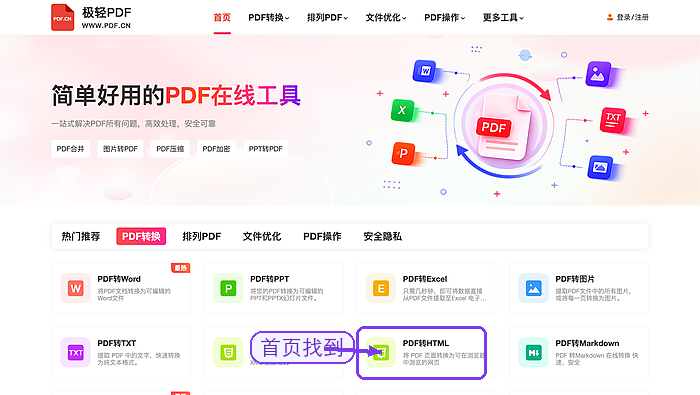
步骤一:找到PDF转HTML入口
在首页的工具分类区找到“PDF转HTML”选项。页面里同类工具很多,先确认好转换方向和输出的文件类型,再点进对应工具页。
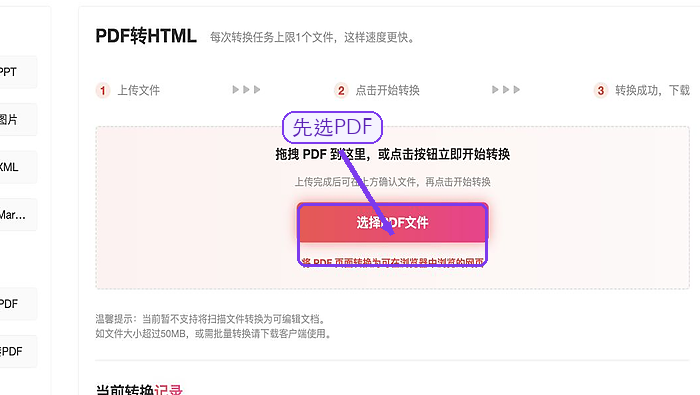
步骤二:上传PDF文件
点上传按钮,选本地存好的PDF文件。上传前最好确认下选的是最终版,别转完才发现传错了旧版本或者临时草稿。
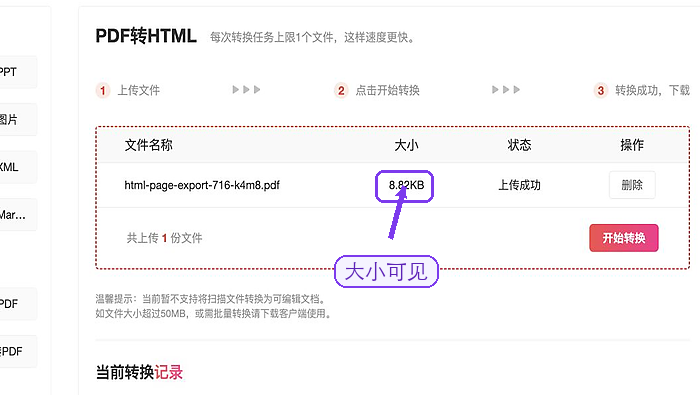
步骤三:确认文件上传状态
文件出现在上传列表后,先核对下文件名、大小和上传状态,尤其是你手头有好几个名字相近的版本时,这一步能避免传错白忙活。
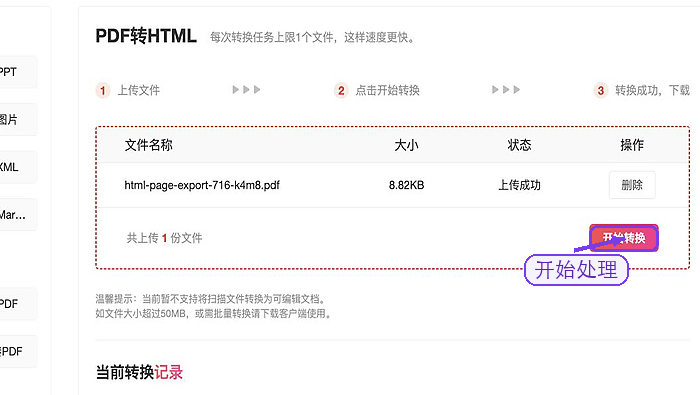
步骤四:开始转换
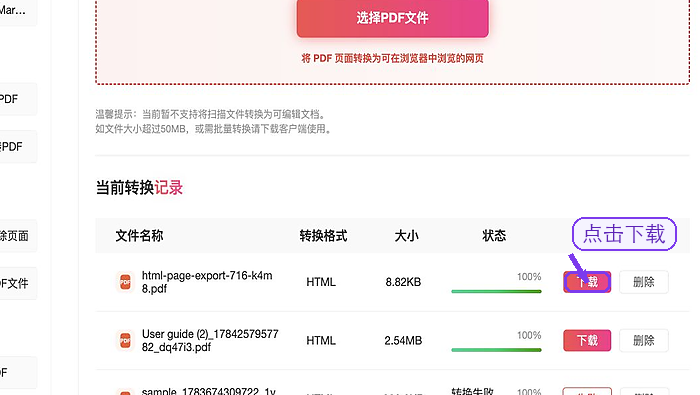
确认选的文件没问题,也不需要调整参数的话,点开始处理就好。转换过程中别刷新页面,等页面提示处理完成再进行下一步。
步骤五:下载HTML并检查
处理完成后直接下载HTML文件。下完先打开检查,重点看页面结构、图片引用、文字顺序有没有问题,确认没问题了再分享给别人、归档或者后续编辑。
方法二:用 Adobe Acrobat 导出 HTML
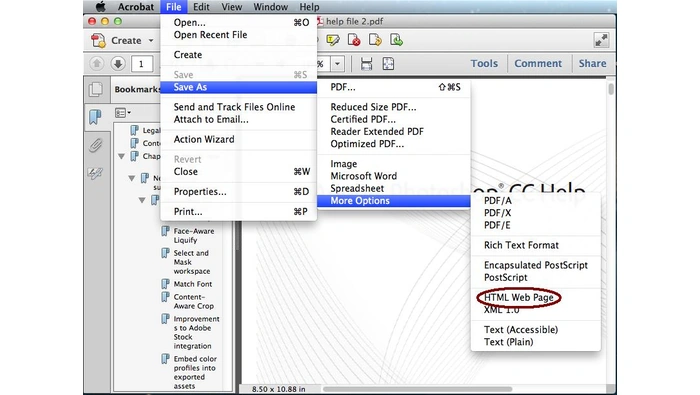
旧版Acrobat XI Pro的菜单里直接有“HTML Web Page”导出选项。新版本的入口可能移到了“导出”菜单下,你按自己装的版本找对应格式就行。
步骤一:打开要转换的 PDF
在Acrobat里打开要转的PDF,先翻几页,确认文字和图片都能正常显示。
步骤二:选择 HTML 网页格式
点开“文件”菜单,选“另存为”或者“导出”,找到“HTML Web Page”选项就行。下面这张图是旧版Acrobat的对应菜单界面。
步骤三:保存并检查网页
选好输出位置点保存。之后用浏览器打开生成的HTML,重点检查段落顺序、图片路径和表格排版是否正常。
方法三:用 ABBYY FineReader 导出 HTML
如果你的PDF是扫描件,先在ABBYY FineReader里检查完文字识别结果,再导出网页文件。12版和14版的菜单位置可能不一样,以你实际看到的界面为准。
步骤一:打开 PDF 并校对识别内容
把PDF导入FineReader,逐页检查文字区域和识别出来的内容。扫描质量差的页面,先校对完再输出更稳妥。
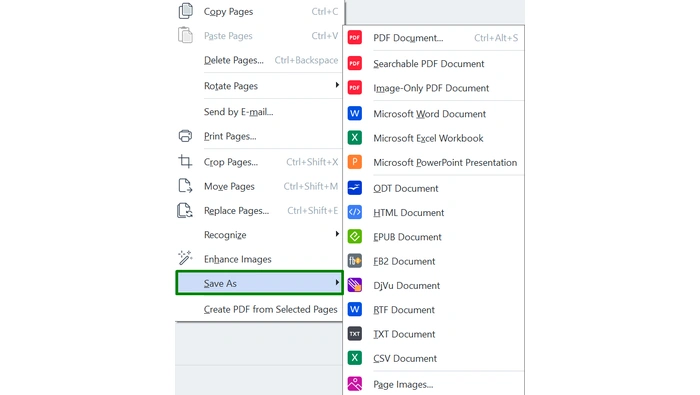
步骤二:选择另存为 HTML
点开“另存为”菜单,选“HTML 文档”,下图就是这个菜单里的格式选项。
步骤三:检查导出结果
保存完用浏览器打开生成的HTML,核对标题、文字顺序、图片和表格。如果页面引用了单独的图片文件,也要确认这些文件没被漏掉。
三种方法转换完,都别只盯着转换成功的提示就完事。网页能不能正常显示、图片引用是否完整,才是最终要确认的结果。