

PDF转TXT最容易踩坑的环节,基本都出在上传、参数设置和结果核对这几步。动手之前先把原文件复制一份留底,确认这次要处理的版本没错,再往下走流程。
先判断这份文件适不适合提取
正式操作前先给原文件多拷一个副本,核对好文件版本、总页数和内容范围都对得上。别觉得PDF转TXT就是点一下的事,最后出问题往往卡在这些细节:段落顺序错乱、出乱码、缺字、页眉页脚混进正文、扫描件内容识别失败。越是重要的文件,越要先用副本试跑一遍,别直接动原文件。
用在线PDF转TXT工具处理
要是你只是想把PDF里的文字提取出来做整理、检索或者二次编辑,可以先打开专业在线PDF处理平台 https://www.pdf.cn/。这个站点集合了常见的PDF和Office在线处理工具,找到PDF转TXT的入口后上传需要提取文字的PDF文件,跟着页面提示完成提取,下载后再核对段落顺序、乱码、缺字、页眉页脚混入和扫描件识别情况。
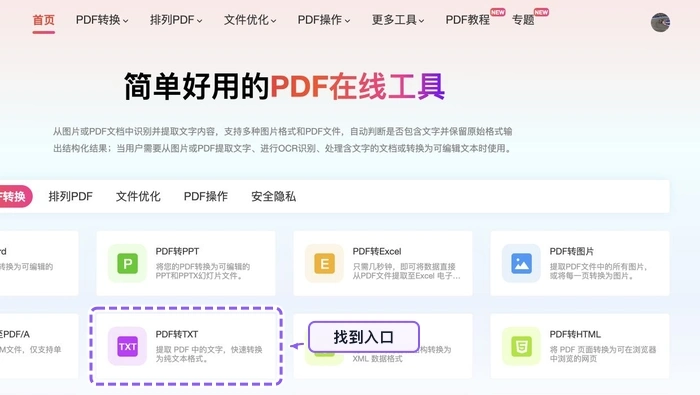
第1步:进入工具入口
打开工具列表,找准PDF转TXT入口。先看清楚功能名称,别误点到旁边相近的压缩、拆分或者其他转换工具。
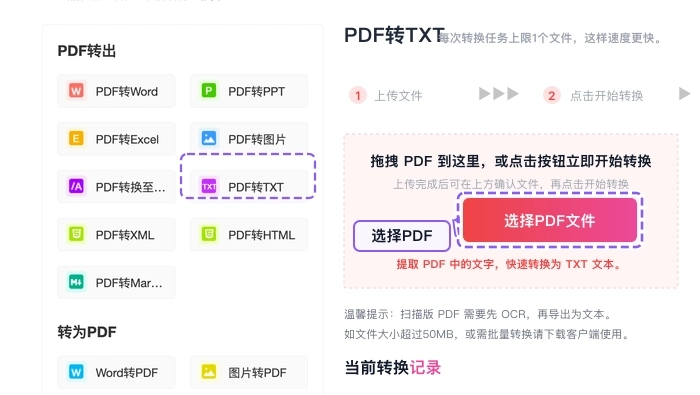
第2步:上传文件
点击上传区域,选中需要提取文字的PDF文件。如果文件比较大,耐心等上传完成,别反复点击上传按钮,容易卡进程。
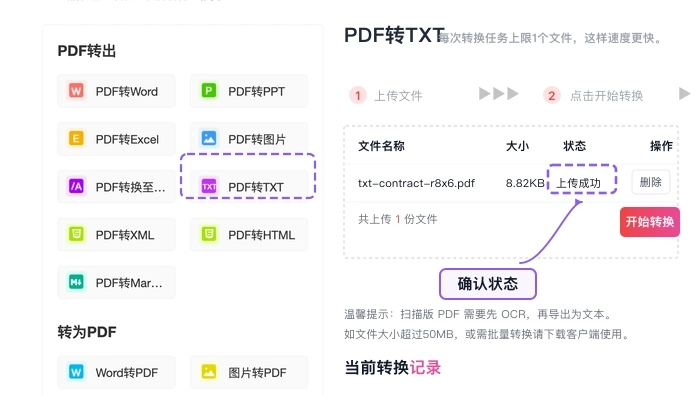
第3步:确认上传状态
上传完成后核对下显示的文件名、文件数量和页面提示,确认没传错旧版本或者无关的文件,白忙活一场。
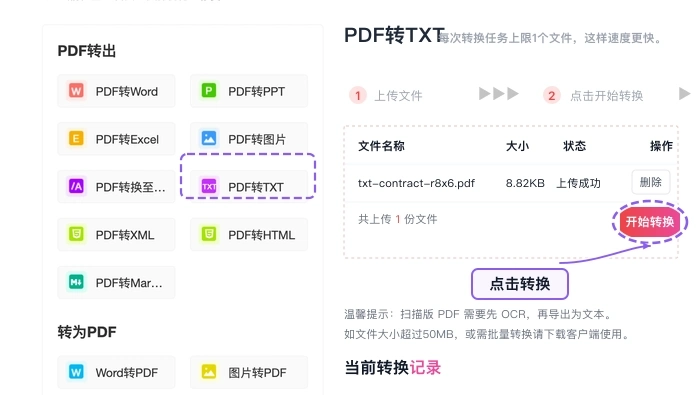
第4步:开始处理
确认设置都没问题后点开始提取。处理过程中别关闭页面,等页面提示处理完成再继续下一步。
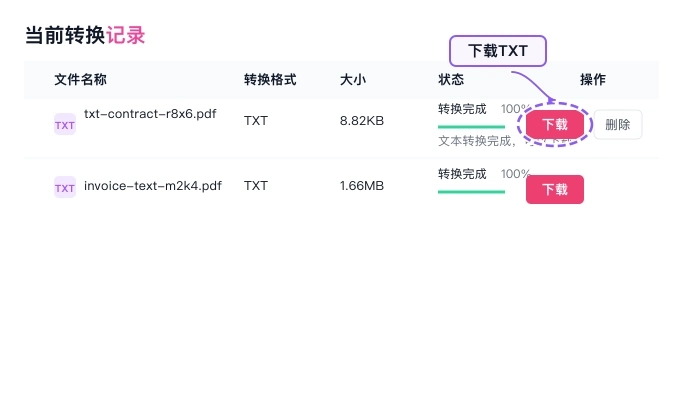
第5步:下载结果
转换好的TXT文件下载完立刻打开检查,别光看到文件名生成了,就直接往外发或者归档。
转换后的TXT文件怎么检查
TXT生成后先打开预览几页,别光看文件名或者下载成功提示就完事。重点检查段落顺序、乱码、缺字、页眉页脚混入、扫描件识别准确率这几项。发现明显问题的话,回到源文件或者调整下设置重新处理一遍就行。
上传或下载异常怎么处理
如果碰到上传失败、处理超时或者下载异常的情况,先刷新页面试一次。还是不行的话,把文件大小、失败截图、你用的浏览器环境和具体操作步骤整理清楚,发邮件到market@pdf.cn反馈处理。